
この CookBook では、Docker Swarm を利用して Payara のクラスタリングを構築する手順について紹介しています。 intra-mart Accel Platform のクラスタリングはこの CookBook では扱いません。 Docker Swarm を利用することで、複数マシンにまたがった仮想 Docker ネットワークを定義し、そのネットワーク上にコンテナをデプロイすることでクラスタリング環境を構築することができます。
レシピ
- Docker Swarm Manager を作成する
- Docker Swarm クラスタに参加する
- Swarm 用 Docker Overlay Network を作成する
- Docker Swarm 用 Hazelcast プラグインを作成する
- Payara の Docker Image を作成する
- Swarm クラスタに Payara タスクをデプロイする
この CookBook では 2 台のマシンを利用します。
| 1 台目 | 2 台目 | |
| 名前 | マシン A | マシン B |
| 役割 | Docker Swarm Manager | Docker Swarm Worker |
| プライベート IP アドレス | 192.168.0.2 | 192.168.0.3 |
マシン A を Docker Swarm クラスタのマネージャーとします。 マシン B をマシン A のクラスタに参加するノードとします。
1. Docker Swarm Manager を作成する
マシン A 上で以下のコマンドを実行します。
docker swarm init --advertise-addr 192.168.0.2
以下のような実行結果が返却されます。
Swarm initialized: current node (xxxxxxxxxxxxxxxxxxxxxxxxx) is now a manager.
To add a worker to this swarm, run the following command:
docker swarm join --token XXXXXX-x-xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx-xxxxxxxxxxxxxxxxxxxxxxxxx 192.168.0.2:2377
To add a manager to this swarm, run 'docker swarm join-token manager' and follow the instructions.
エラーが出た場合 2377 ポートを他のプログラムが使用していないか確認してください。2377 ポートが利用できない場合 --listen-addr フラグを指定することで他のポートを使用することも可能です。 返却された実行結果の docker swarm join --token ... のコマンドをコピーします。
2. Docker Swarm クラスタに参加する
マシン B 上で、先ほどコピーしたコマンドを実行します。
docker swarm join --token XXXXXX-x-xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx-xxxxxxxxxxxxxxxxxxxxxxxxx 192.168.0.2:2377
以下のような実行結果が返却されます。 This node joined a swarm as a worker. マシン A 上で以下のコマンドを実行します。
docker node ls
以下のような実行結果が返却されます。
ID HOSTNAME STATUS AVAILABILITY MANAGER STATUS ENGINE VERSION xxxxxxxxxxxxxxxxxxxxxxxxx * machine-a Ready Active Leader 18.03.1-ce yyyyyyyyyyyyyyyyyyyyyyyyy machine-b Ready Active 18.03.1-ce
マシン A とマシン B の 2 ノードで構成されていることが確認できます。
3. Swarm 用 Docker Overlay Network を作成する
マシン A 上で以下のコマンドを実行します
docker network create -d overlay --subnet=172.16.0.0/24 payara-cluster
-d overlay を指定することで、Docker Swarm の各ノード上でまたがって利用可能なオーバーレイネットワークを作成します。 ここで作成したネットワークを Docker Swarm の各ノード内で利用する仮想的なネットワークとします。 マシン A 上で以下のコマンドを実行します
docker network ls
以下のように、NAME=payara-cluster, DRIVER=overlay, SCOPE=swarm のネットワークが作成されていることが確認できます。
NETWORK ID NAME DRIVER SCOPE xxxxxxxxxxxx bridge bridge local yyyyyyyyyyyy docker_gwbridge bridge local zzzzzzzzzzzz host host local wwwwwwwwwwww ingress overlay swarm uuuuuuuuuuuu none null local vvvvvvvvvvvv payara-cluster overlay swarm
SCOPE=swarm となっていることから分かるように、オーバーレイネットワークは Docker Swarm と組み合わせた場合のみ利用可能です。 docker run --net=payara-cluster のような利用はできません。
4. Docker Swarm 用 Hazelcast プラグインを作成する
Hazelcast でクラスタリングを構成するためのプラグインを作成します。 のちの手順で「payara-service」という名称でタスクをデプロイするため、DNS「tasks.payara-service」で各サーバのプライベート IP を取得できます。 この DNS からクラスタに参加するノードを返却するプラグインを作成します。
hazelcast_config/src/main/java/com/hazelcast/swarm/HazelcastSwarmDiscoveryStrategy.java
package com.hazelcast.swarm;
import java.util.List; import java.util.Map;
import com.hazelcast.logging.ILogger; import com.hazelcast.spi.discovery.AbstractDiscoveryStrategy; import com.hazelcast.spi.discovery.DiscoveryNode;
final class HazelcastSwarmDiscoveryStrategy extends AbstractDiscoveryStrategy { private final EndpointResolver endpointResolver;
HazelcastSwarmDiscoveryStrategy(final ILogger logger, final Map<String, Comparable> properties) {
    super(logger, properties);

    EndpointResolver endpointResolver;
    endpointResolver = new ServiceEndpointResolver(logger);
    logger.info("Swarm Discovery activated resolver: " + endpointResolver.getClass().getSimpleName());
    this.endpointResolver = endpointResolver;
}

@Override
public void start() {
    endpointResolver.start();
}

@Override
public Iterable<DiscoveryNode> discoverNodes() {
    return endpointResolver.resolve();
}

@Override
public void destroy() {
    endpointResolver.destroy();
}

abstract static class EndpointResolver {
    protected final ILogger logger;

    EndpointResolver(final ILogger logger) {
        this.logger = logger;
    }

    abstract List<DiscoveryNode> resolve();

    void start() {
    }

    void destroy() {
    }
}
}
hazelcast_config/src/main/java/com/hazelcast/swarm/HazelcastSwarmDiscoveryStrategyFactory.java
package com.hazelcast.swarm;
import java.util.Arrays; import java.util.Collection; import java.util.Collections; import java.util.Map;
import com.hazelcast.config.properties.PropertyDefinition; import com.hazelcast.logging.ILogger; import com.hazelcast.spi.discovery.DiscoveryNode; import com.hazelcast.spi.discovery.DiscoveryStrategy; import com.hazelcast.spi.discovery.DiscoveryStrategyFactory;
public class HazelcastSwarmDiscoveryStrategyFactory implements DiscoveryStrategyFactory {
private static final Collection
static {
    PROPERTY\_DEFINITIONS = Collections.unmodifiableCollection(Arrays.asList());
}

@Override
public Class<? extends DiscoveryStrategy> getDiscoveryStrategyType() {
    return HazelcastSwarmDiscoveryStrategy.class;
}

@Override
public DiscoveryStrategy newDiscoveryStrategy(final DiscoveryNode discoveryNode, final ILogger logger, final Map<String, Comparable> properties) {
    return new HazelcastSwarmDiscoveryStrategy(logger, properties);
}

@Override
public Collection<PropertyDefinition> getConfigurationProperties() {
    return PROPERTY\_DEFINITIONS;
}
}
hazelcast_config/src/main/java/com/hazelcast/swarm/ServiceEndpointResolver.java
package com.hazelcast.swarm;
import java.net.InetAddress; import java.net.UnknownHostException; import java.util.ArrayList; import java.util.List; import java.util.concurrent.TimeUnit;
import com.hazelcast.logging.ILogger; import com.hazelcast.nio.Address; import com.hazelcast.spi.discovery.DiscoveryNode; import com.hazelcast.spi.discovery.SimpleDiscoveryNode;
class ServiceEndpointResolver extends HazelcastSwarmDiscoveryStrategy.EndpointResolver { protected final ILogger logger;
ServiceEndpointResolver(final ILogger logger) {
    super(logger);
    this.logger = logger;
}

public InetAddress\[\] queryAllByName(final String name) throws UnknownHostException {
    final InetAddress\[\] addresses = InetAddress.getAllByName(name);

    return addresses;
}

public void waitForDnsAvailable() { // 「tasks.payara-service」で IP が引けるようになるまで待機
    for (;;) {
        try {
            final InetAddress\[\] addresses = queryAllByName("tasks.payara-service");

            if (addresses != null) {
                break;
            }
        } catch (final Exception ignore) {
        }

        try { TimeUnit.SECONDS.sleep(1); } catch (final InterruptedException ignore) {}
    }
}

@Override
List<DiscoveryNode> resolve() {
    waitForDnsAvailable();

    try {
        final List<DiscoveryNode> result = new ArrayList<DiscoveryNode>();
        final InetAddress\[\] addresses = queryAllByName("tasks.payara-service");

        for (final InetAddress address : addresses) {
            logger.info("Discoved node: " + address.getHostAddress());

            result.add(makeDiscoveryNode(address.getHostAddress(), 5701)); // DAS
            result.add(makeDiscoveryNode(address.getHostAddress(), 5702)); // インスタンス
        }

        return result;
    } catch (final Exception e) {
        throw new RuntimeException(e.getLocalizedMessage(), e);
    }
}

DiscoveryNode makeDiscoveryNode(final String host, final int port) throws UnknownHostException {
    final Address address = new Address(host, port);
    final SimpleDiscoveryNode discoveryNode = new SimpleDiscoveryNode(address, address);

    return discoveryNode;
}
}
hazelcast_config/src/main/resources/META-INF/services/com.hazelcast.spi.discovery.DiscoveryStrategyFactory
com.hazelcast.swarm.HazelcastSwarmDiscoveryStrategyFactory
hazelcast_config/pom.xml
<groupId>jp.co.intra\_mart</groupId>
<artifactId>hazelcast\_config</artifactId>
<packaging>jar</packaging>
<version>8.0.0</version>

<name>hazelcast\_config</name>

<dependencies>
    <dependency>
        <groupId>com.hazelcast</groupId>
        <artifactId>hazelcast</artifactId>
        <version>3.9.3</version>
    </dependency>
</dependencies>

<build>
    <plugins>
        <plugin>
            <artifactId>maven-compiler-plugin</artifactId>
            <version>2.3.2</version>
            <configuration>
                <source>1.8</source>
                <target>1.8</target>
            </configuration>
        </plugin>
    </plugins>
</build>
DNS からアドレスを引き、クラスタリングに参加させています。 対象の DNS 名を ServiceEndpointResolver.java に直接記載しているため、他のサービス名を利用したい場合変更しコンパイルしなおしてください。 ソースコードは hazelcast_config.zip からダウンロードできます。
5. Payara の Docker Image を作成する
Dockerfile
ベースイメージとして /cookbook/cookbook147109/ で作成したイメージを利用します。
FROM mypayara:5.182
COPY hazelcast-config.xml /var/payara/payara/glassfish/domains/domain1/config/hazelcast-config.xml COPY hazelcast_config-8.0.0.jar /var/payara/payara/glassfish/lib/hazelcast_config-8.0.0.jar
CMD /run.sh
作成した Hazelcast プラグインが動作するように hazelcast-config.xml と先ほど作成した Hazelcast プラグイン(hazelcast_config-8.0.0.jar) を追加しています。 マシン A, マシン B の両方で、mypayara_swarm というタグでビルドします。
docker build -t mypayara_swarm:5.182 .
(イメージを DockerHub に push している場合、Worker ノードは自動的に pull するためすべてのノード上でビルドする必要はなくなります。)
hazelcast-config.xml
  <discovery-strategies>
    <discovery-strategy enabled="true" class="com.hazelcast.swarm.HazelcastSwarmDiscoveryStrategy">
      <properties></properties>
    </discovery-strategy>
  </discovery-strategies>
</join>
6. Swarm クラスタに Payara タスクをデプロイする
マシン A 上で、以下のコマンドでタスクをデプロイします。
docker service create \ --name payara-service \ --replicas 2 \ --network payara-cluster \ --publish published=2222,target=22 \ --publish published=4848,target=4848 \ --publish published=8080,target=8080 \ --publish published=28080,target=28080 \ --hostname="{{.Service.Name}}-{{.Task.Slot}}" \ mypayara_swarm:5.182
サービス名「payara-service」、レプリカ数 = 2, ネットワークは先ほど作成した「payara-cluster」でサービスを作成します。 レプリカを 2 個にしているため、マシン A, マシン B 上にデプロイされます。 以下のコマンドで、どのマシン上で実行されているかを確認できます。
docker service ps payara-service
マシン A, マシン B 上で実行されていることが確認できます。
ID NAME IMAGE NODE DESIRED STATE CURRENT STATE ERROR PORTS xxxxxxxxxxxx payara-service.1 mypayara_swarm:5.182 machine-a Running Running 10 minutes ago xxxxxxxxxxxx payara-service.2 mypayara_swarm:5.182 machine-b Running Running 10 minutes ago
コンテナのホスト名の設定(--hostname)は本来不要ですが、ここでは分かりやすい名前にすることを優先して設定しています。 コンテナの Payara が利用する 4848, 8080, 28080 ポート(target)をそのままホスト側の 4848, 8080, 28080 ポート(published)で開放しています。 そのため、http://192.168.0.2:4848 から管理コンソールにアクセスできます。 管理コンソールの DataGrid を確認することで、クラスタリングが組まれていることを確認できます。 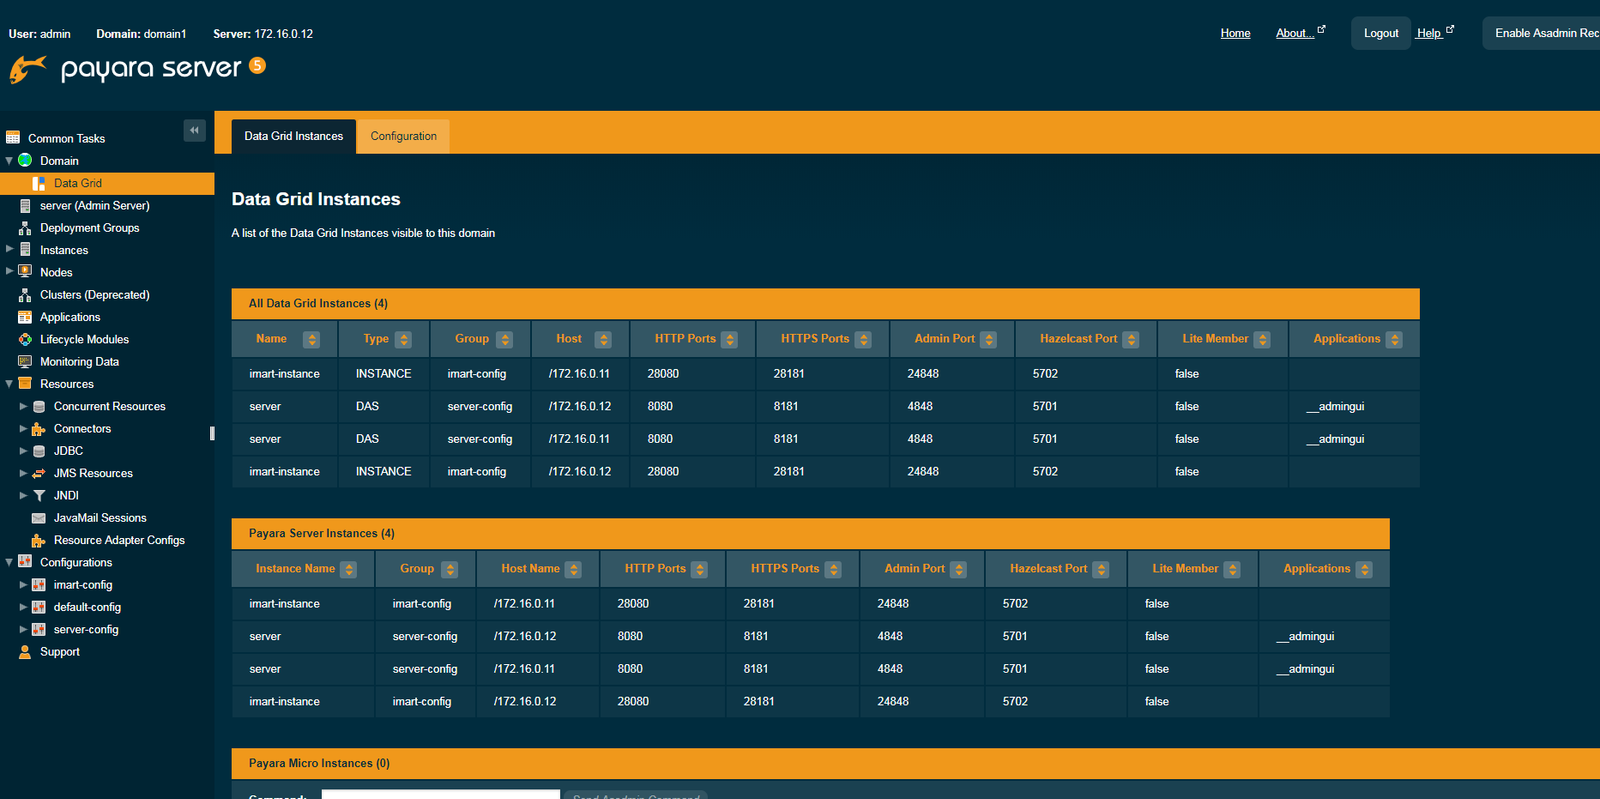
まとめ
このように、Docker Swarm を利用することで、複数マシン上での Payara クラスタリング環境を構築できます。 この CookBook では Payara がもつ Hazelcast 機能を用いて Payara のみのクラスタリングを構築しました。 intra-mart Accel Platform をデプロイする場合、JGroups のクラスタリングの設定も必要です。 その場合、今回の手順では network-agent-config.xml に IP アドレスを列挙することを事前に行えないため、本 CookBook の手順は使えませんので、注意してください。 また、今回の Hazelcast プラグインを用いてクラスタリングを構成する方法が難しい場合、単に replica=1 として二回タスクをデプロイ後、それぞれのタスクのプライベート IP を調査し、それぞれの管理コンソールの DataGrid よりそれぞれのマシンの IP アドレスをコンマ区切りで列挙し設定する方法でもクラスタリングを構築することが可能です。 併せてご活用ください。